open-connections就是以前的smart connections的开源替代,原因是后者将以前免费的功能直接弄成了订阅制,要么你就不升级用旧版本,要么就用这些第三方了。
但是呢,open-connections有一些正常地球人根本无法理解的问题,比如我这次关注的:永远只会向量化非常少的一部分笔记。
比如这样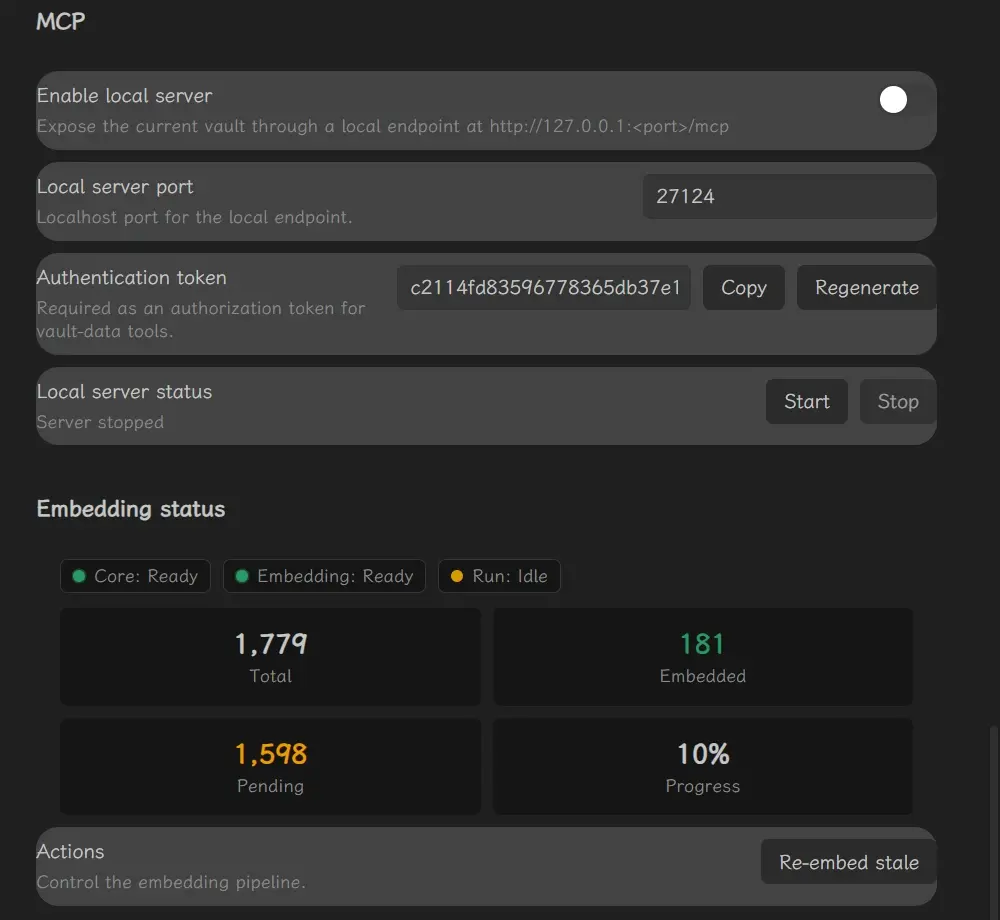
就算是你选择了Re-embed,也只不过就是将之前导入的笔记重新显示一次,并没有"导入全库"的功能。
只有每次重启obsidian和点开新的笔记本的时候,插件会看心情给你多导入一点,其他时候一律卡在50条,哪怕你的笔记有几千条也永远如此。
这不是给全库笔记扫描和做关联笔记的吗?就导入几十条意义何在?
经过我实测,如果只导入了1/10不到,返回的关联笔记完全就是牛头不对马嘴,没有任何实际意义。
这次让Ai分析了下这个插件的代码库,发现导入50篇笔记就直接停止是代码写死的,本来就这么设计的,所以我才说这插件有的地方是正常人很难理解的。
绕过插件逻辑强制调用#
目前,我已经将该问题和对应的方案反馈到了GitHub ,到底改不改短期我是不清楚的,但是现在你可以跟我一样用代码绕过插件内部逻辑,直接调用全库导入功能,基本实现可以正常使用。
在obsidian使用快捷键"Ctrl+Shift+i"打开控制台,直接粘贴然后运行一下代码。
const p = app.plugins.plugins['open-connections'];
console.log('当前嵌入配置:', p.getCurrentModelInfo(), '| 状态:', p.status_state);
const all = p.source_collection.all;
const noBlocks = all.filter(s => p.block_collection.for_source(s.key).length === 0);
console.log(`总计 ${all.length} 篇;已有块 ${all.length - noBlocks.length} 篇;待解析 ${noBlocks.length} 篇`);
let i = 0;
for (const s of noBlocks) {
  try {
    if (!s.file) s.file = app.vault.getAbstractFileByPath(s.key);
    await p.block_collection.import_source_blocks(s);
  } catch (e) { console.warn('解析失败:', s.key, e); }
  if (++i % 100 === 0) {
    await p.block_collection.data_adapter.save();
    console.log(`解析进度 ${i}/${noBlocks.length}`);
    await new Promise(r => setTimeout(r, 20));
  }
}
await p.block_collection.data_adapter.save();
console.log('块解析完成,提交全量嵌入任务');
await p.reembedStaleEntities('console: full vault embed');
console.log('嵌入结束,查看设置页 Embedded 计数');
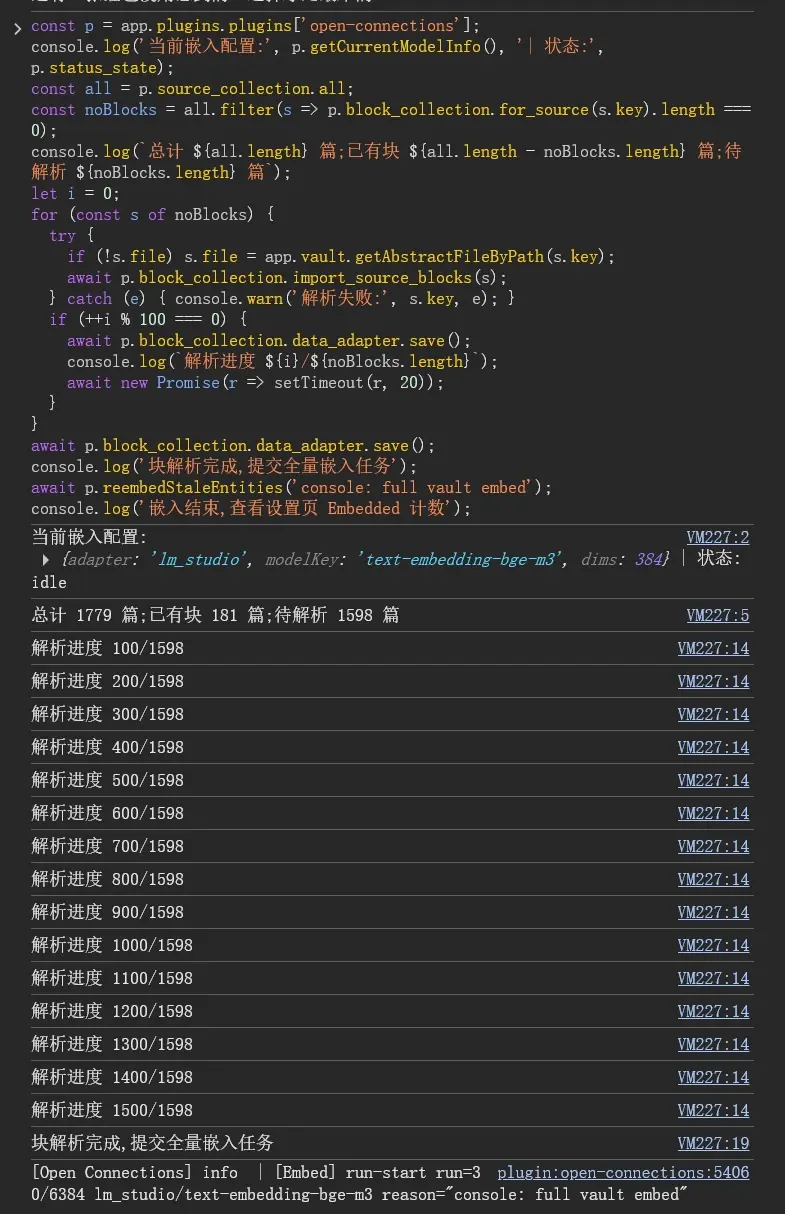
这时候你可以去看下你配置的后端,比如Lmstudio,如果发现模型计算一直在运转,就说明你正在导入笔记,如果没反应空转,就说明哪里有明显的问题。
像下面这样就是预期的运行结果。

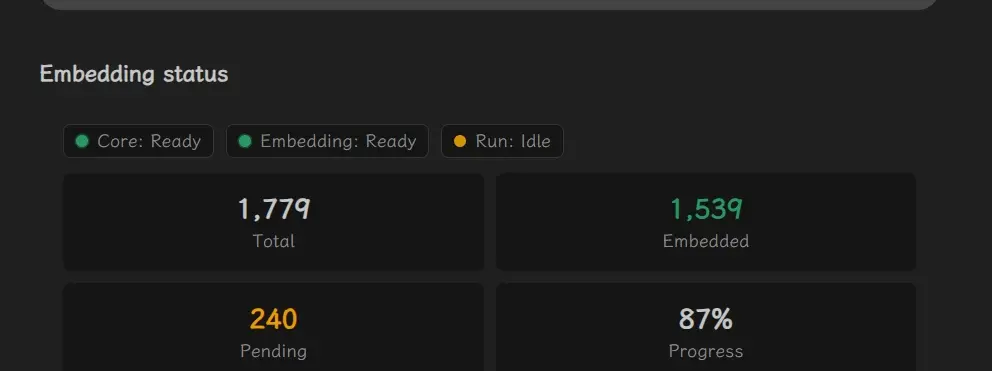
最后可以查看下状态,现在是87%了,因为插件内置了过滤,过于短小的笔记是不会做任何处理的。
截止2026-10-02,以上内容依然有效。
使用导致的后果请自负,我不做任何保证。
注:代码使用Ai书写。