2023年我发布过Calibre Ebook翻译器的提示词,2025年我还做了下修订。
到2026年初期龙虾爆火,我就已经打算将提示词系统转换到循环agents工作流了。写这篇文章,就是因为我已经做完了这事。
Ebook translator插件一直不兼容MCP,而且作者好像也无视了我的功能请求,于是,当然就只能自己做了。
这次我专门Ai辅助下为该插件编写了通用标准MCP,可以在任何兼容标准MCP的智能体中使用。
至于智能体,我选的是DSH框架,主要是我考虑到这东西开源而且人气火热,应该能长期存在,数据安全风险也很低。
为何非要用Calibre+MCP+agents的组合?
这就不得不说我这么做的优势了。
如果你用别人打包好的框架,通常这些框架要么就是个"黑盒",几乎无法自定义,更无法随意修改译文,随意修改术语表,做不到任何时候都能做回溯性修改。
而且,这些打包的工具,根本做不到翻译时对话决策,直接一条道走到黑。
通常这些工具还不会输出关键决策思考过程,没办法做项目总览监控。
当然,还有的干脆就是功能残缺了,没有做统一的翻译后审校流程,质量难以保证。
如果用agents框架,以上全部都能满足。任何时候有想法,立即告诉Ai,立即对过去或者未来做出修改。
MCP也可以直接识别哪些书本没有翻译完全,哪些没对齐。但凡只要你有其他想法,都能通过MCP直接重新读取,重新翻译,重新写入。
想要不同风格?没问题,重新建一个缓存,直接再来一次。
复制粘贴太麻烦?没事,MCP都包揽了。
翻译到中期,才发现以前的内容翻译错了,想要回改,完全是在大海捞针?直接中断对话告诉Ai,直接查找出所有翻译错的位置,分分钟全部重做重译重写。
Ai翻译的上下文局限在附近两节?在agents框架中,随时可以调用进度和记忆文件知道大概的情节,再read和grep工具阅读和查询以前的任何内容,对书本的理解远远不只是待翻译内容的上下两节!
如果你愿意,还可以将整本书做成向量数据库,随时让agents通过语义去查询以前的复杂关系。(我是个人用途,暂时没有这样做的计划)。
原版Calibre插件有个非常严重的缺陷——对大模型的主持非常落后。不同API提供商的API调用方法都不太一样,每个模型也不太一样,想要使用大模型在Calibre ebook translator中使用,其实很麻烦。
所以,我发现很多人只在这个插件中使用免费的微软和谷歌翻译,这下是省事了,但是就比较遗憾。
如果是对话式精修翻译,那很可能要被硬控一整天。如果是自动翻译,又有一些缺点,虽然可以睡一觉就翻译好。
如果直接转换成markdown文本翻译,那么大量的转换工作和格式就处理起来很麻烦了。Calibre ebook translator的EPUB解析和回归引擎很成熟,这就是为何基于它来做的原因。
好消息是,以上问题我都基本克服了。
对话智能体的优势就是你想自定义轻而易举,提示词并不是写死的,你想要什么功能,随时可以添加,几乎没有限制,这是你选择第三方打包好的框架几乎不可能实现的。
想要做好基本的决策就去睡觉?完全可以,授权agents自主进行多轮工作就行。
为什么不添加更多agents多轮执行?当然是因为钱包不够鼓。你要是愿意完全可以自己加。
我当然不是说我做的这个小工具和框架尽善尽美,但是我可以肯定说这足够满足我自己迅速看上任何原版书的需求了,对大部分读者来说也一样。
现在先放几张图,开源项目正在编辑中没有完全发布,等正式发布时候我将再写一篇。
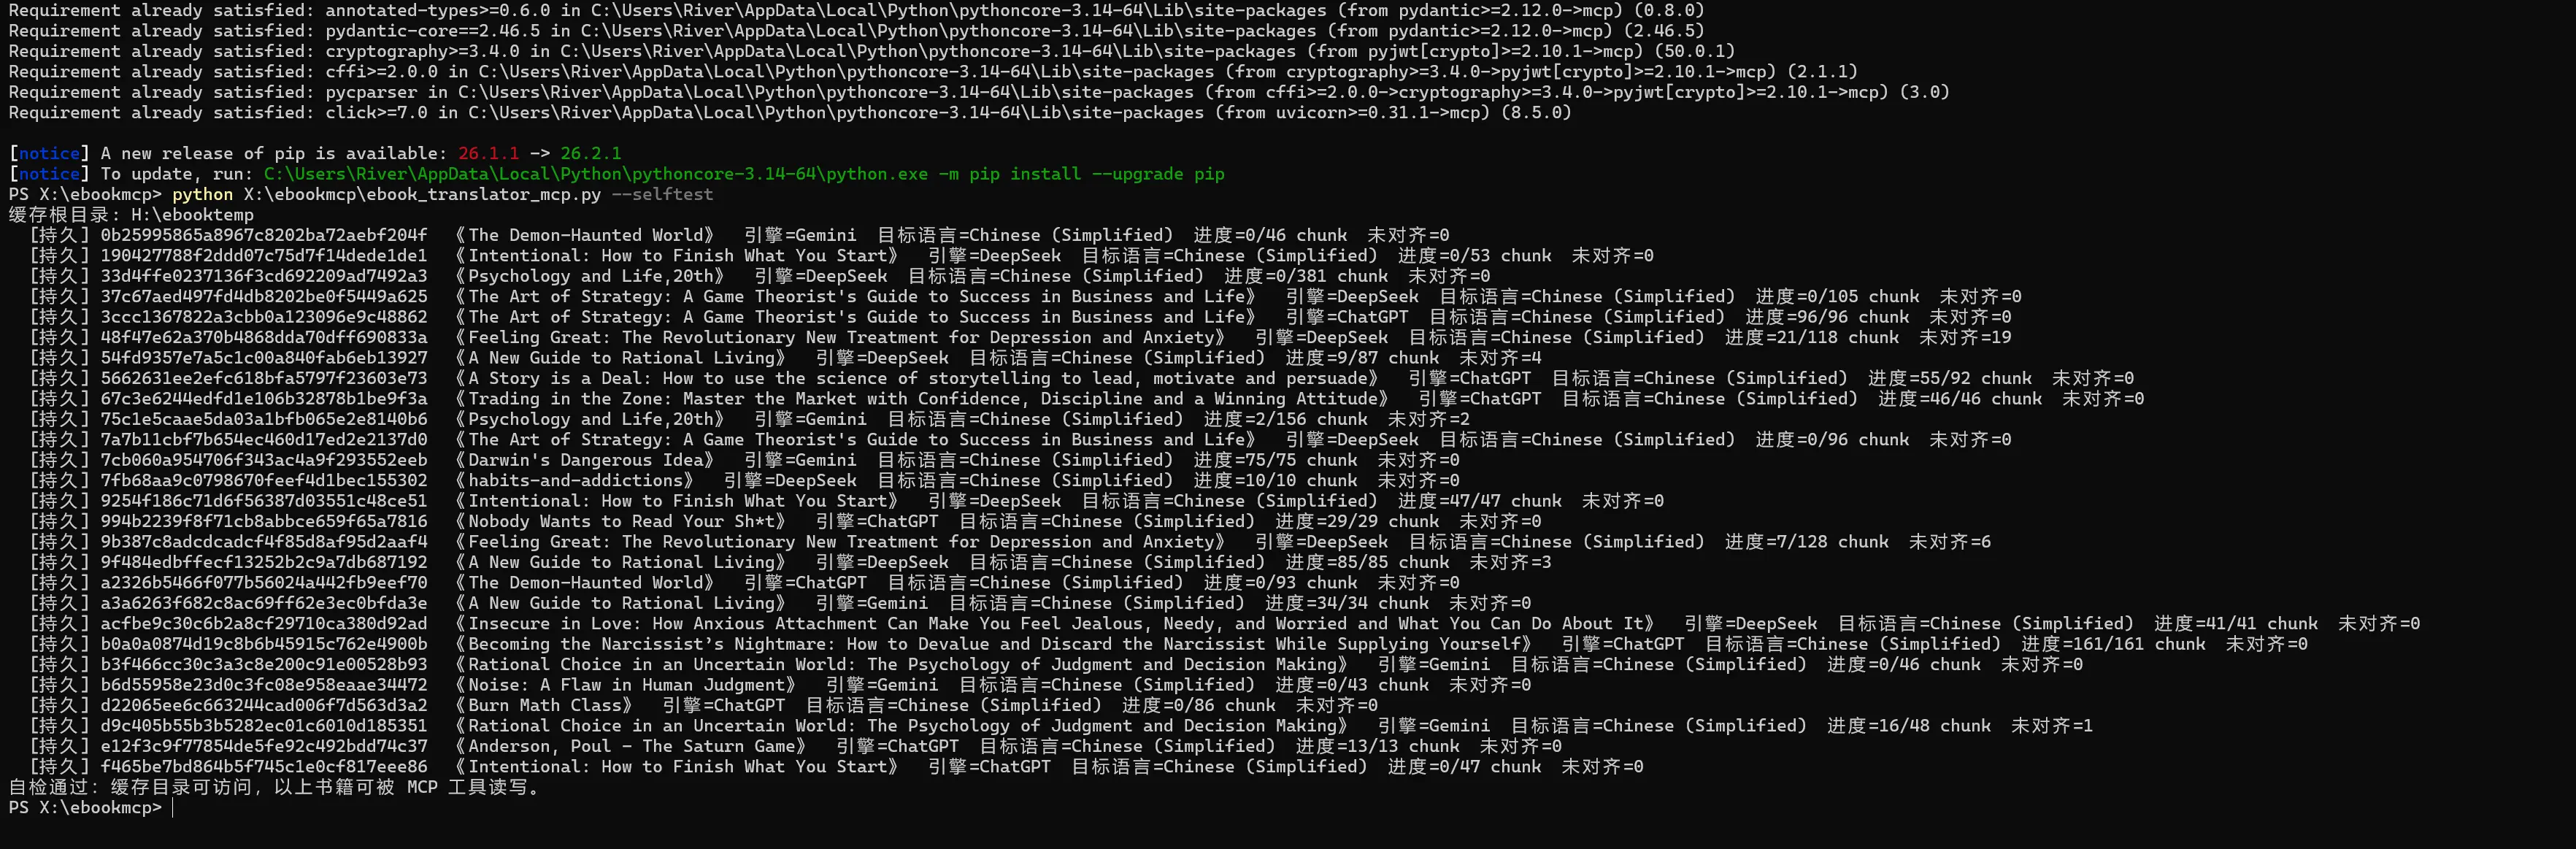
图 MCP程序自检,成功识别到翻译缓存
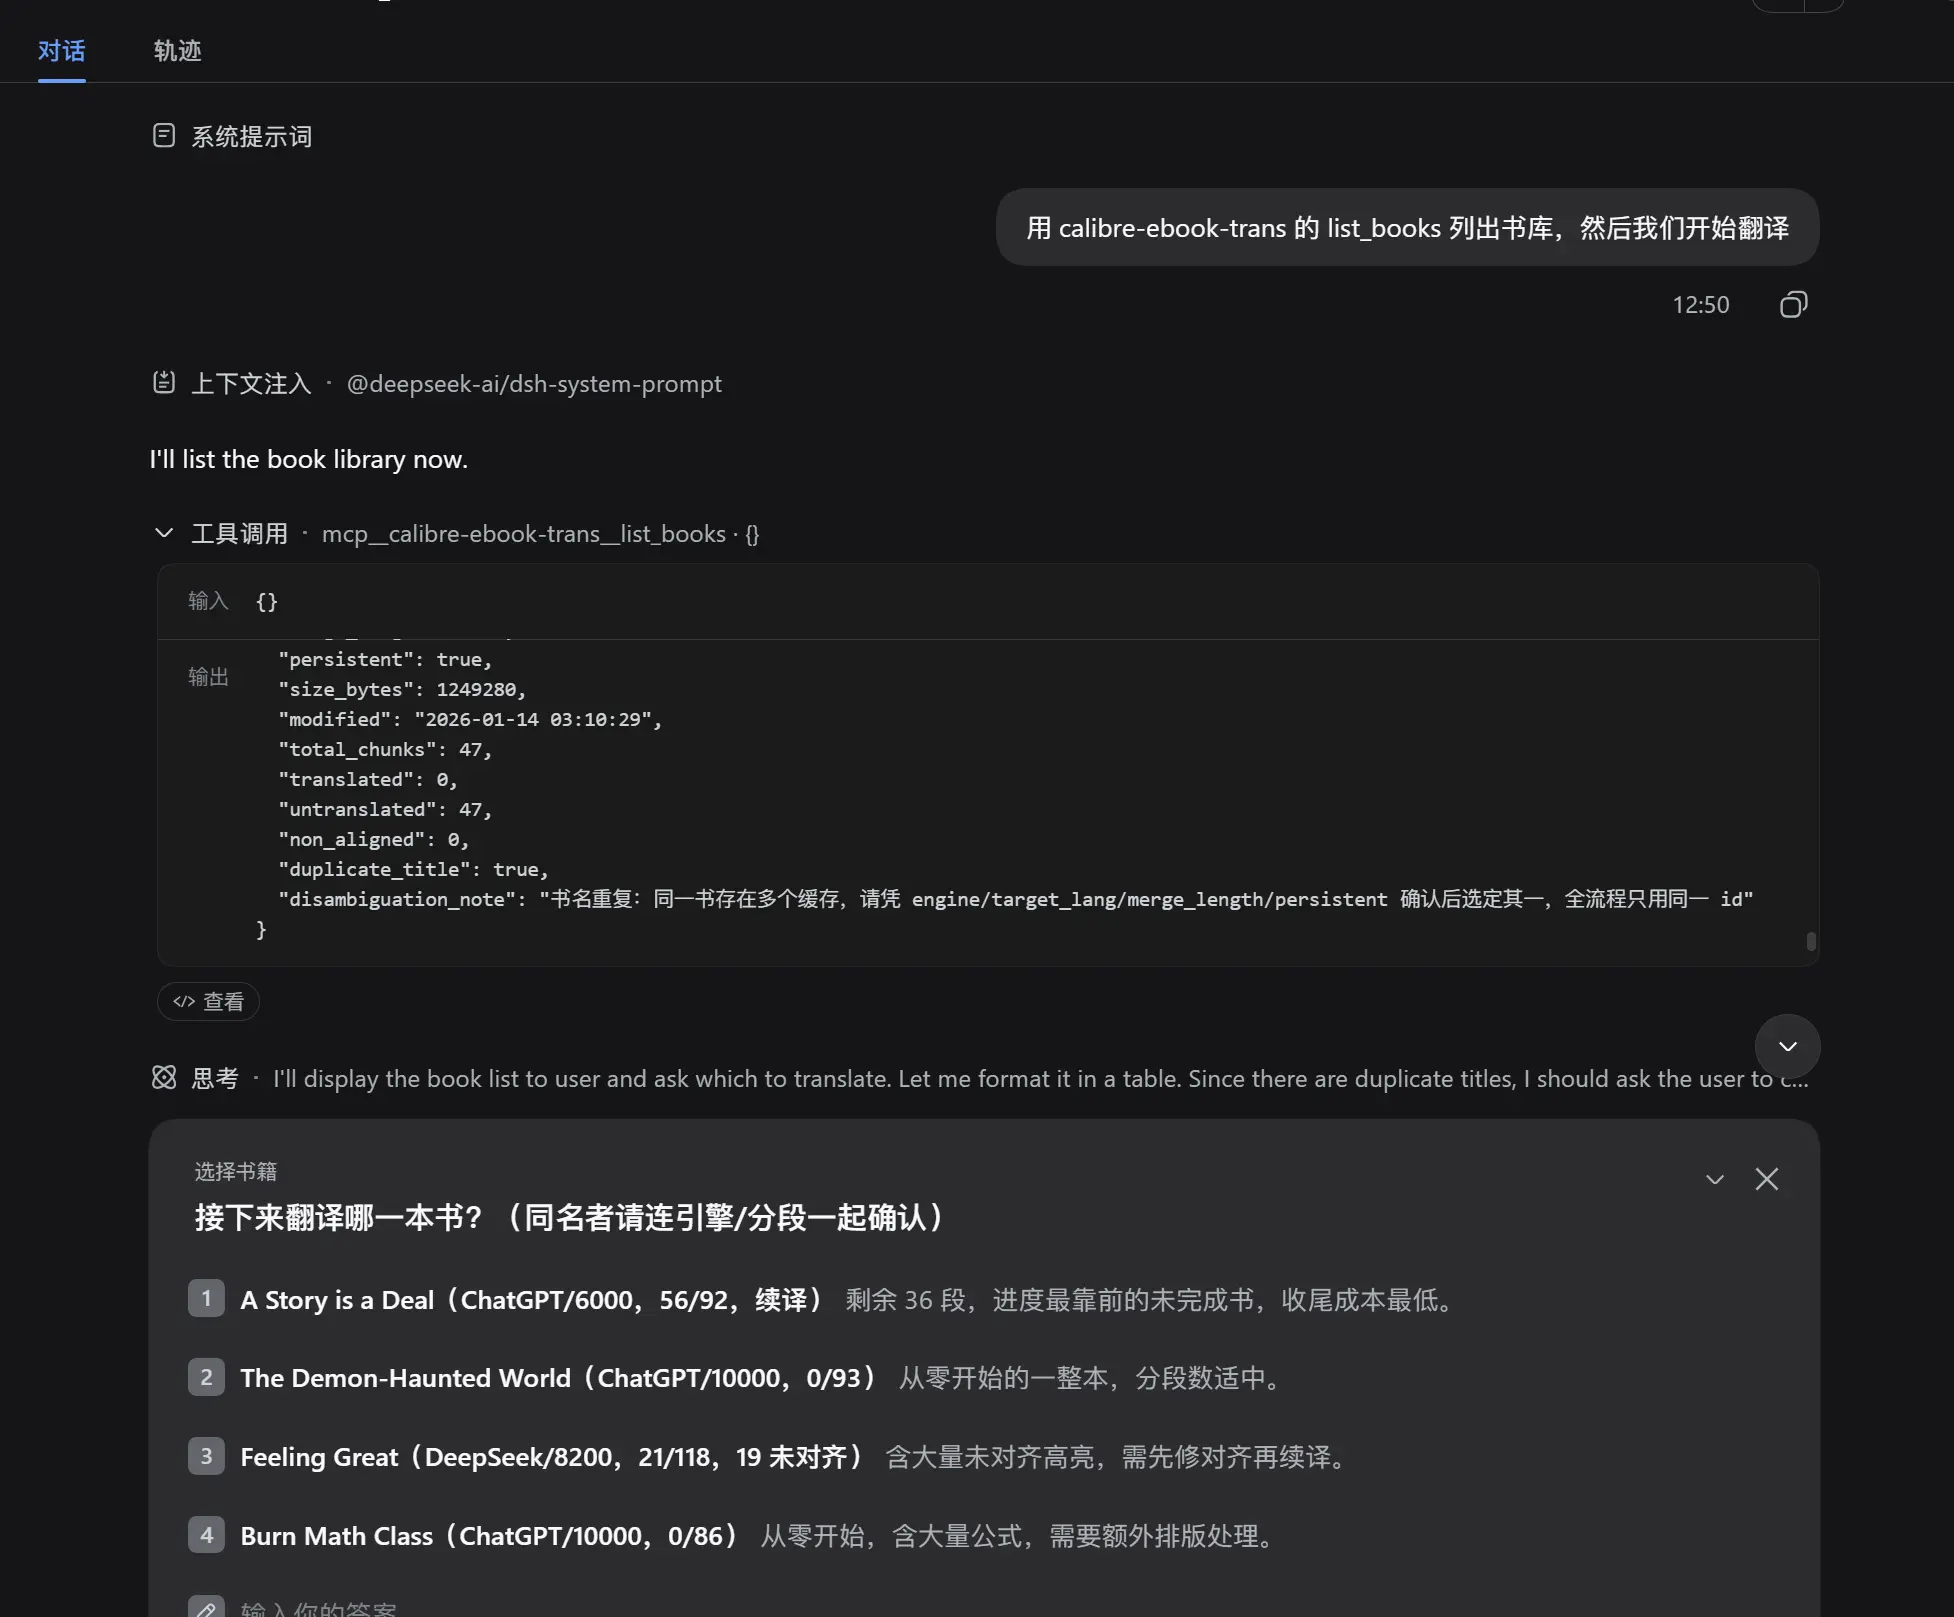
图 agents框架成功调用MCP,识别到不同的书籍信息。
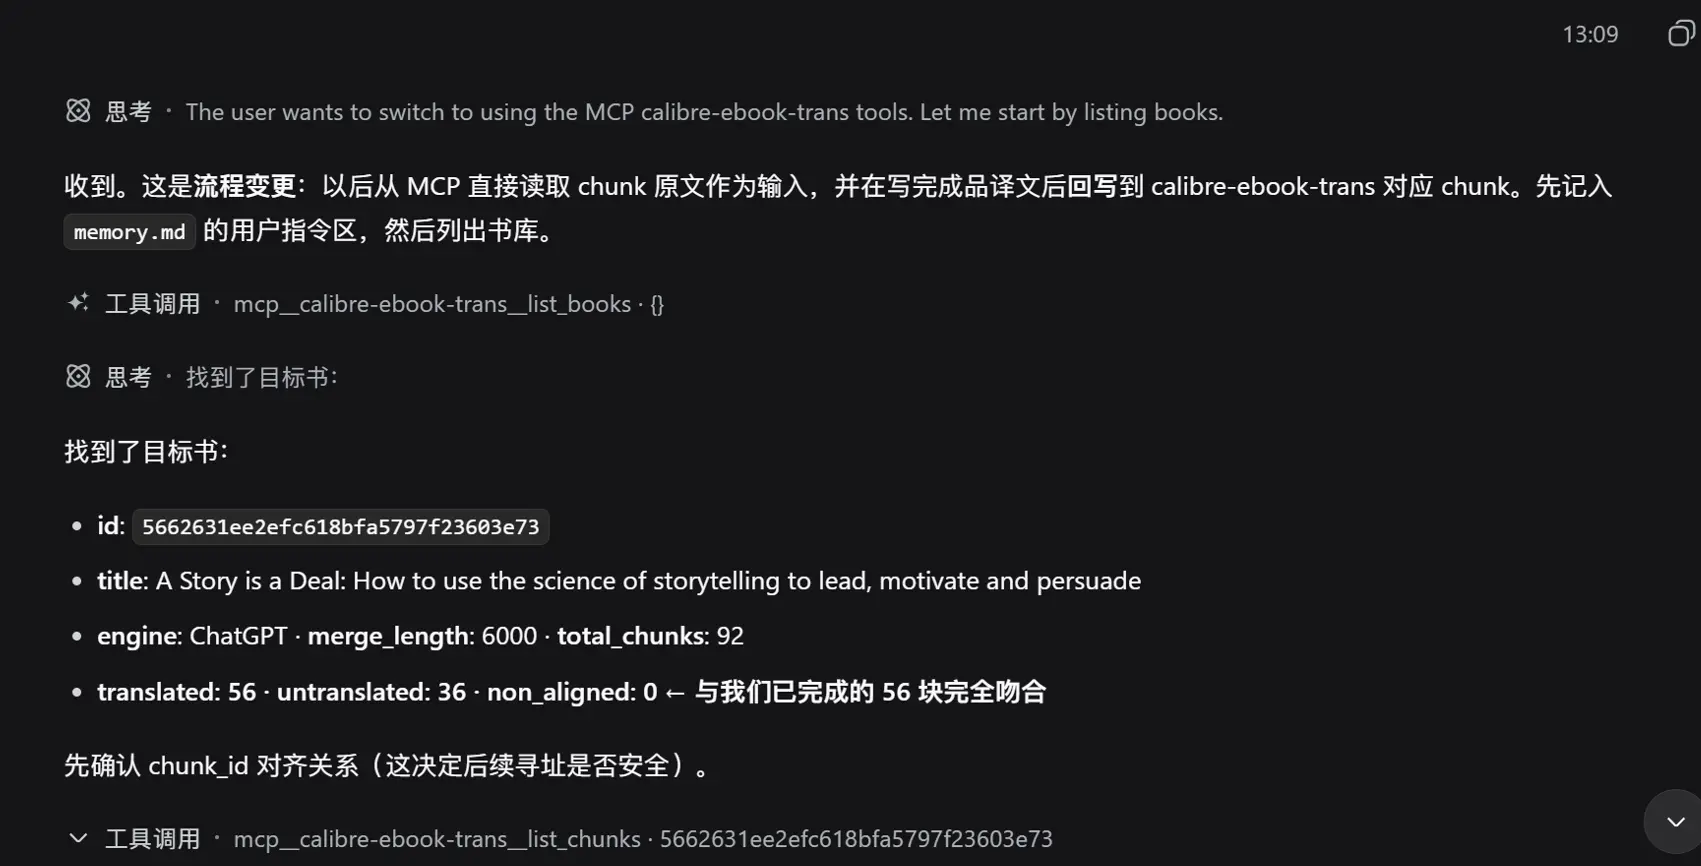
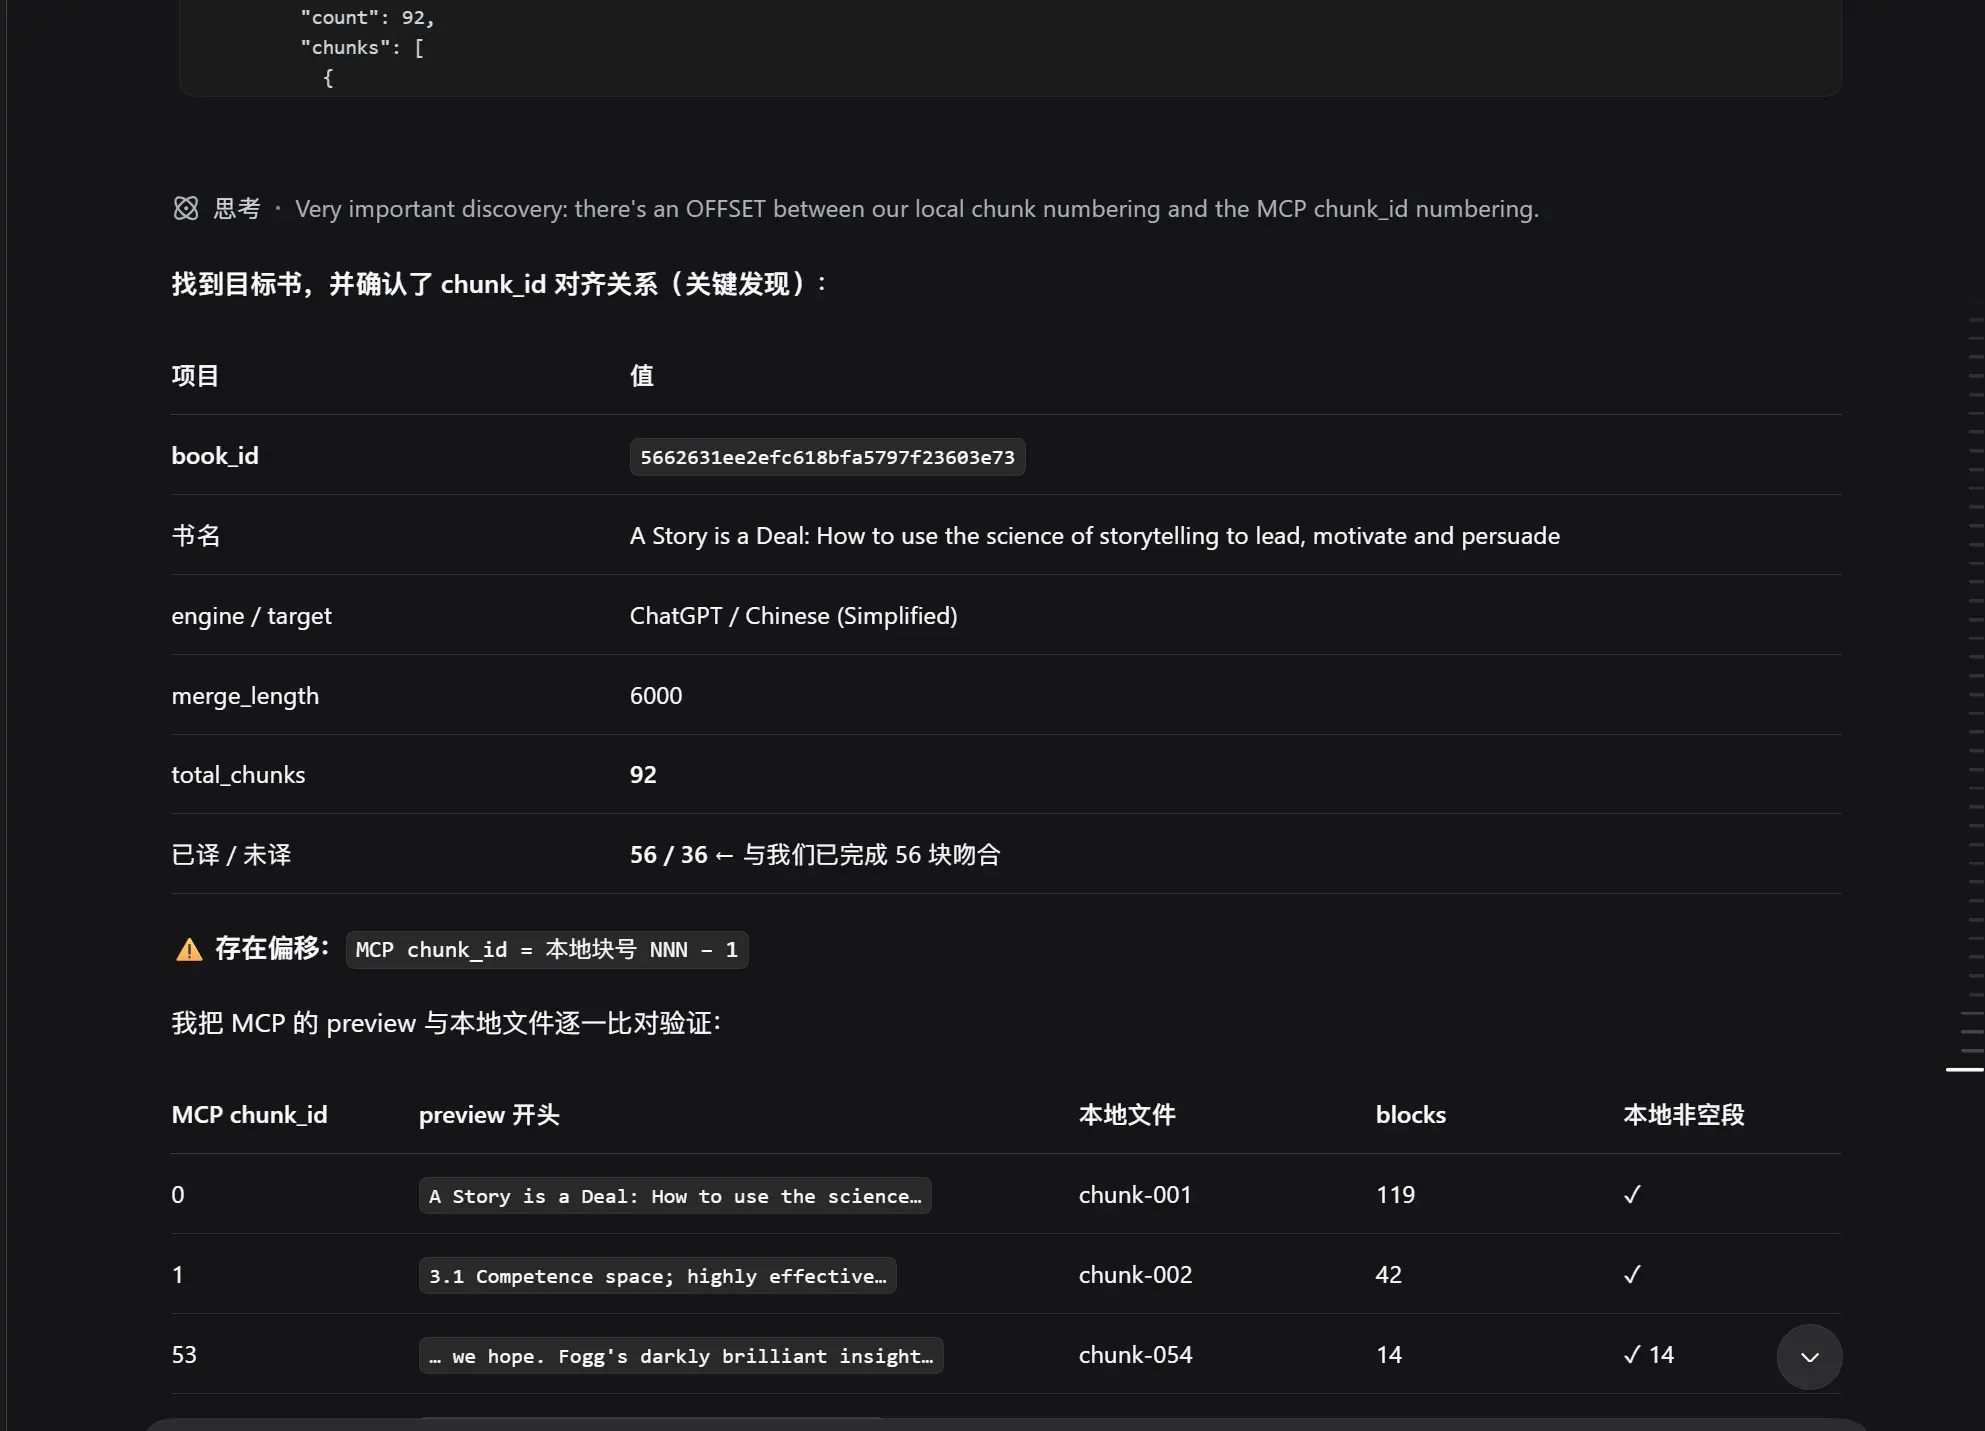
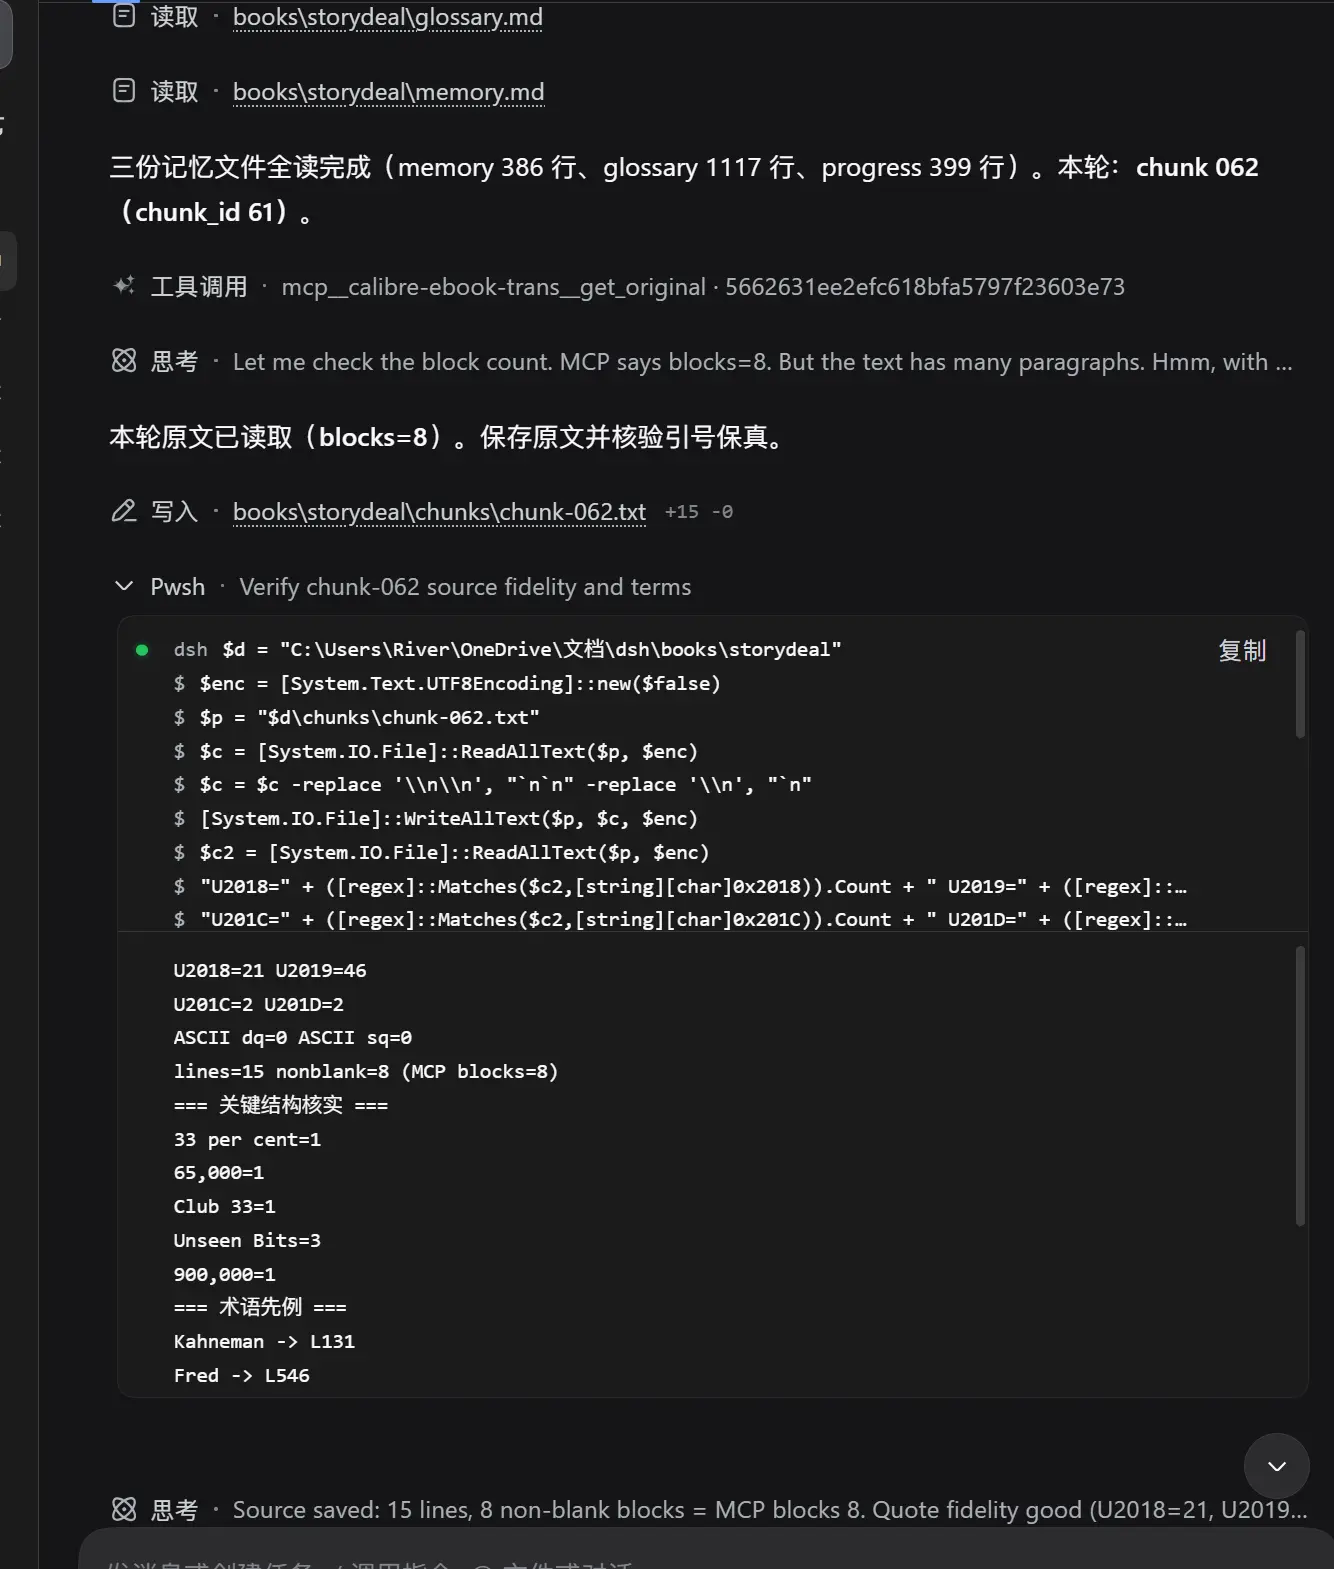
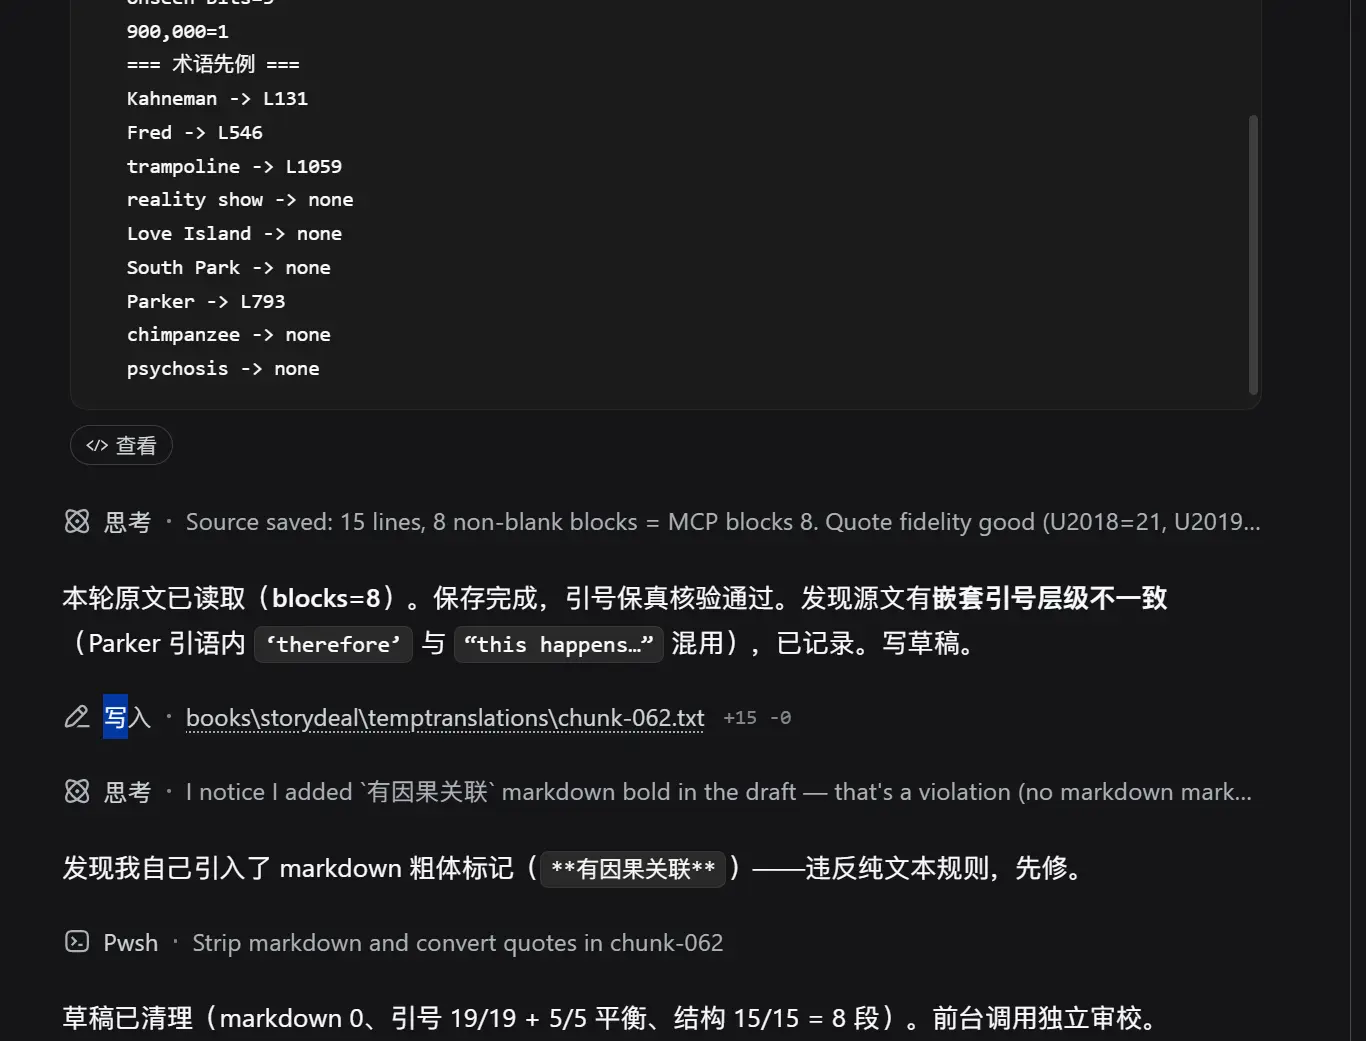
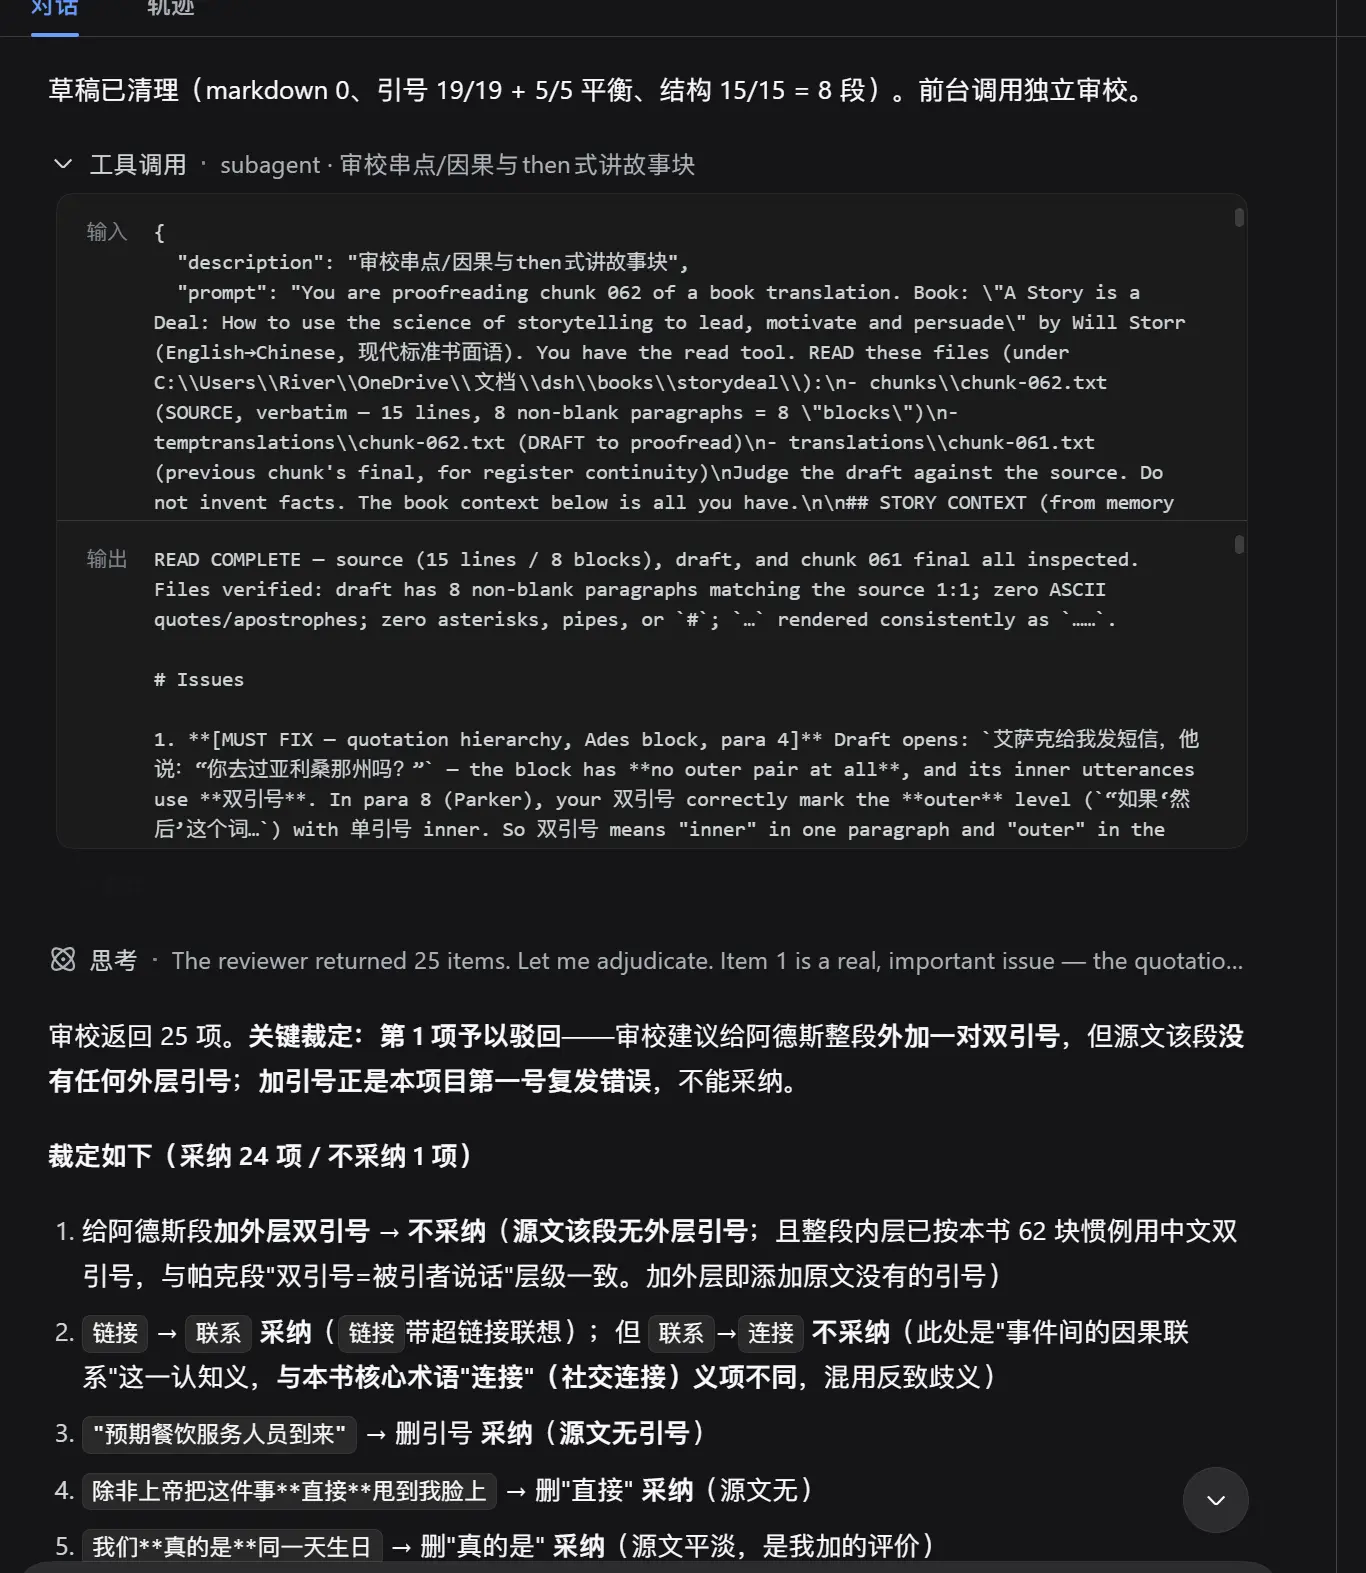
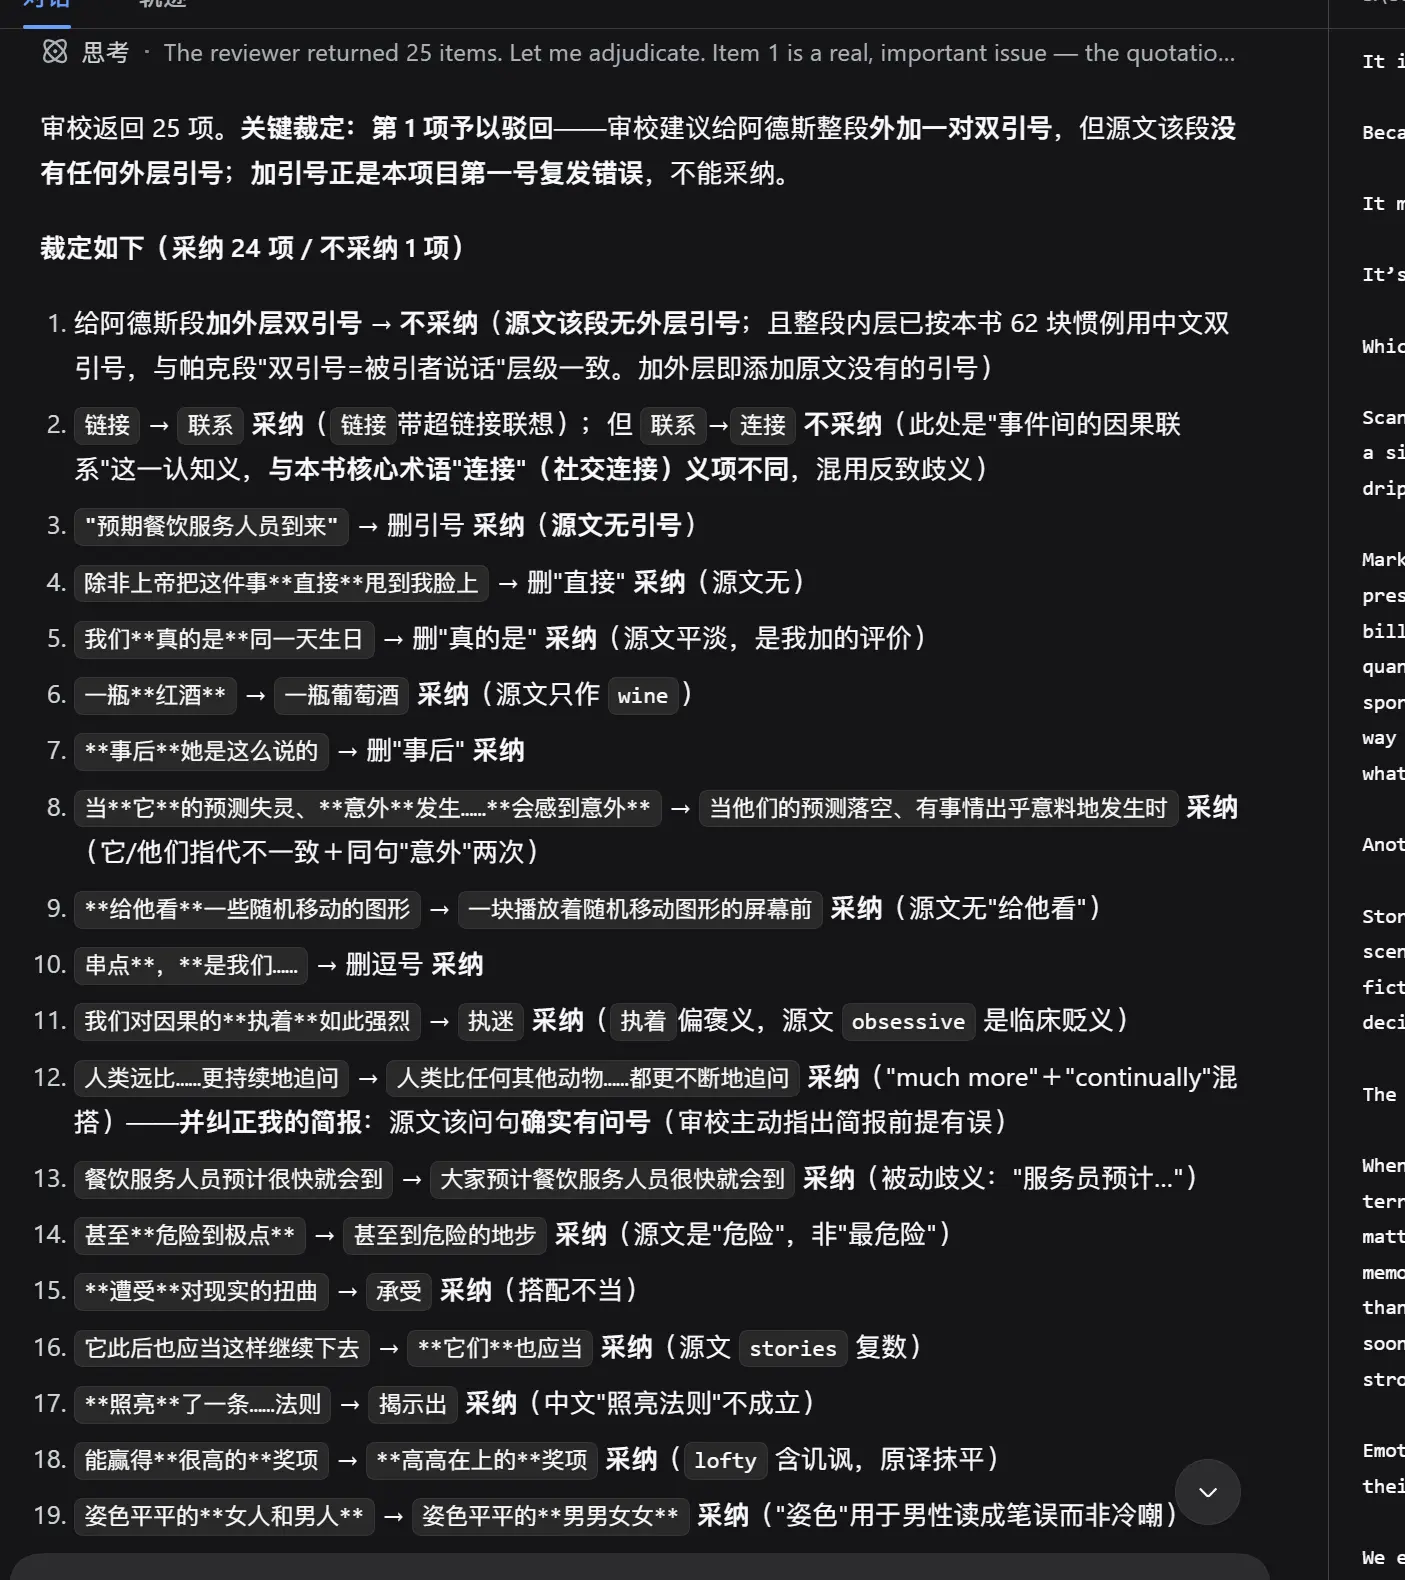
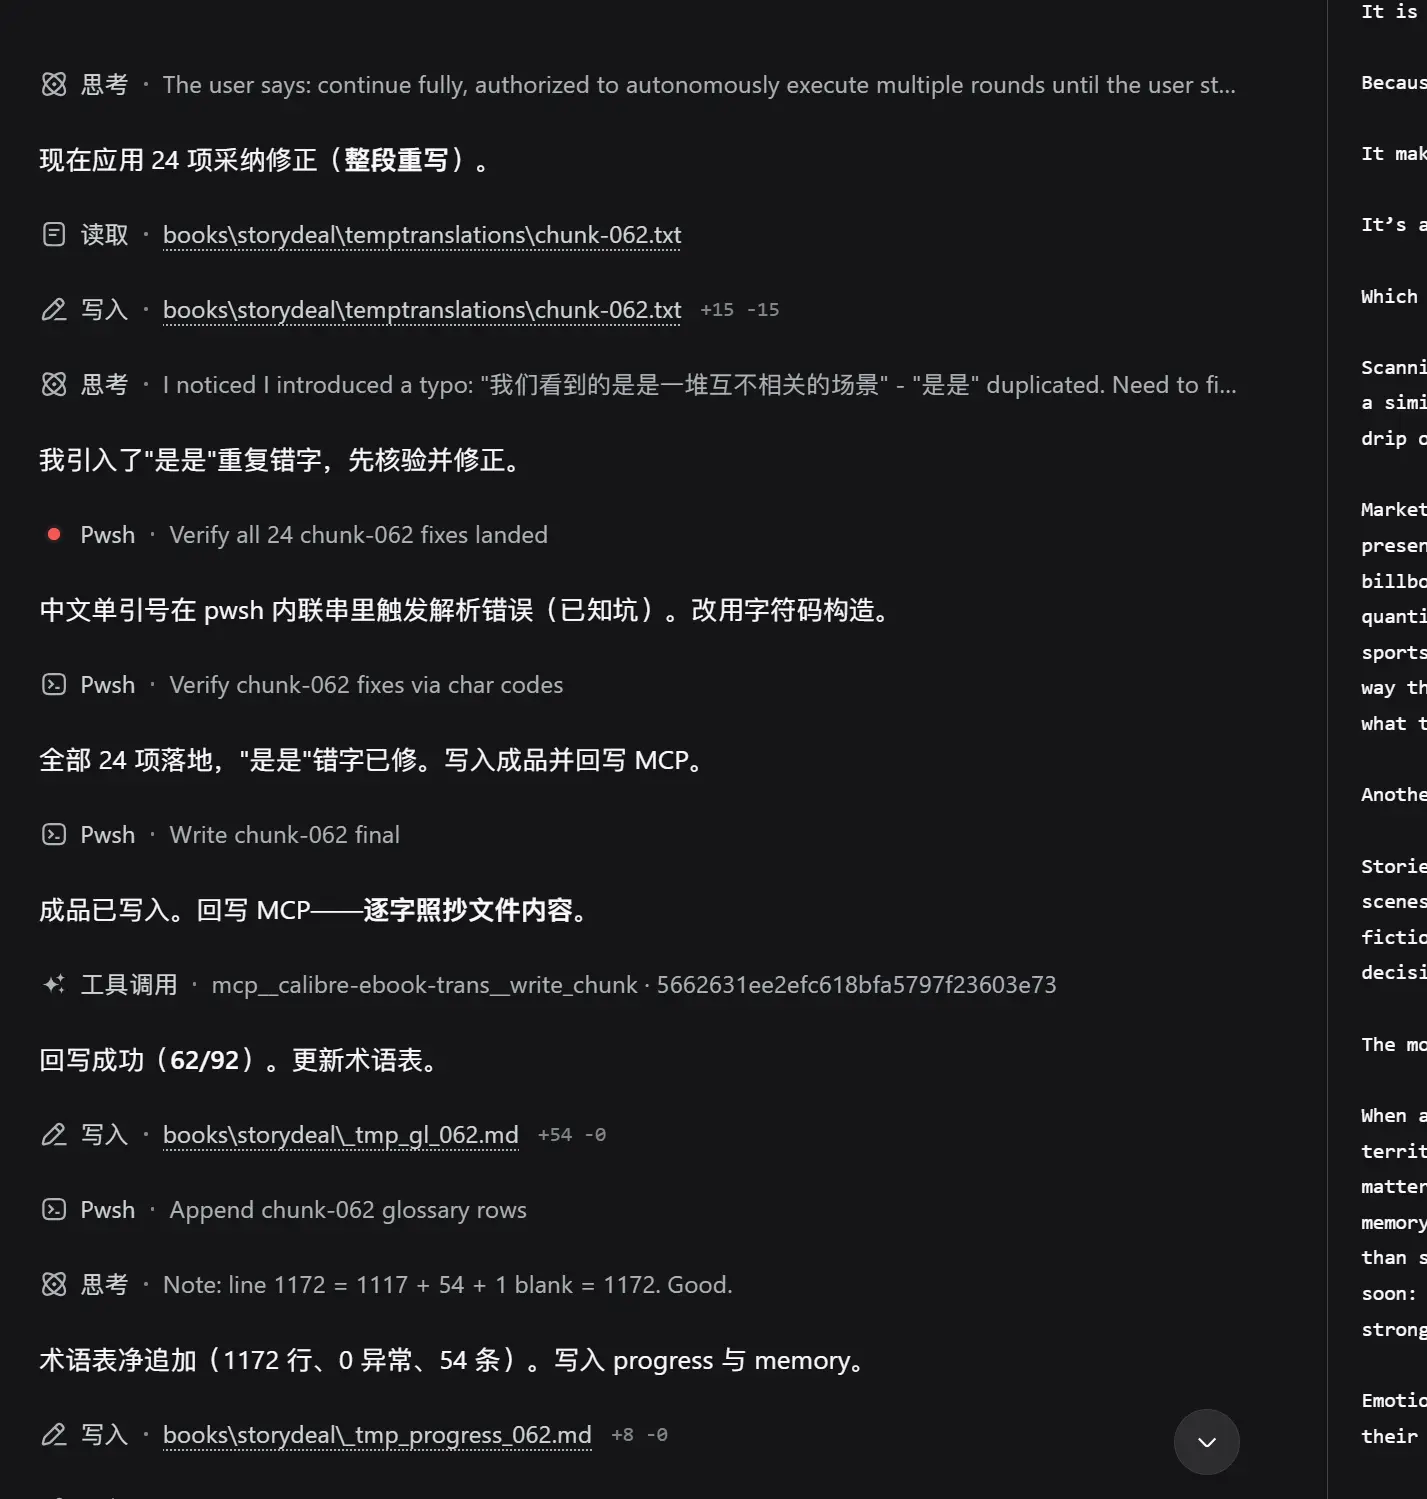
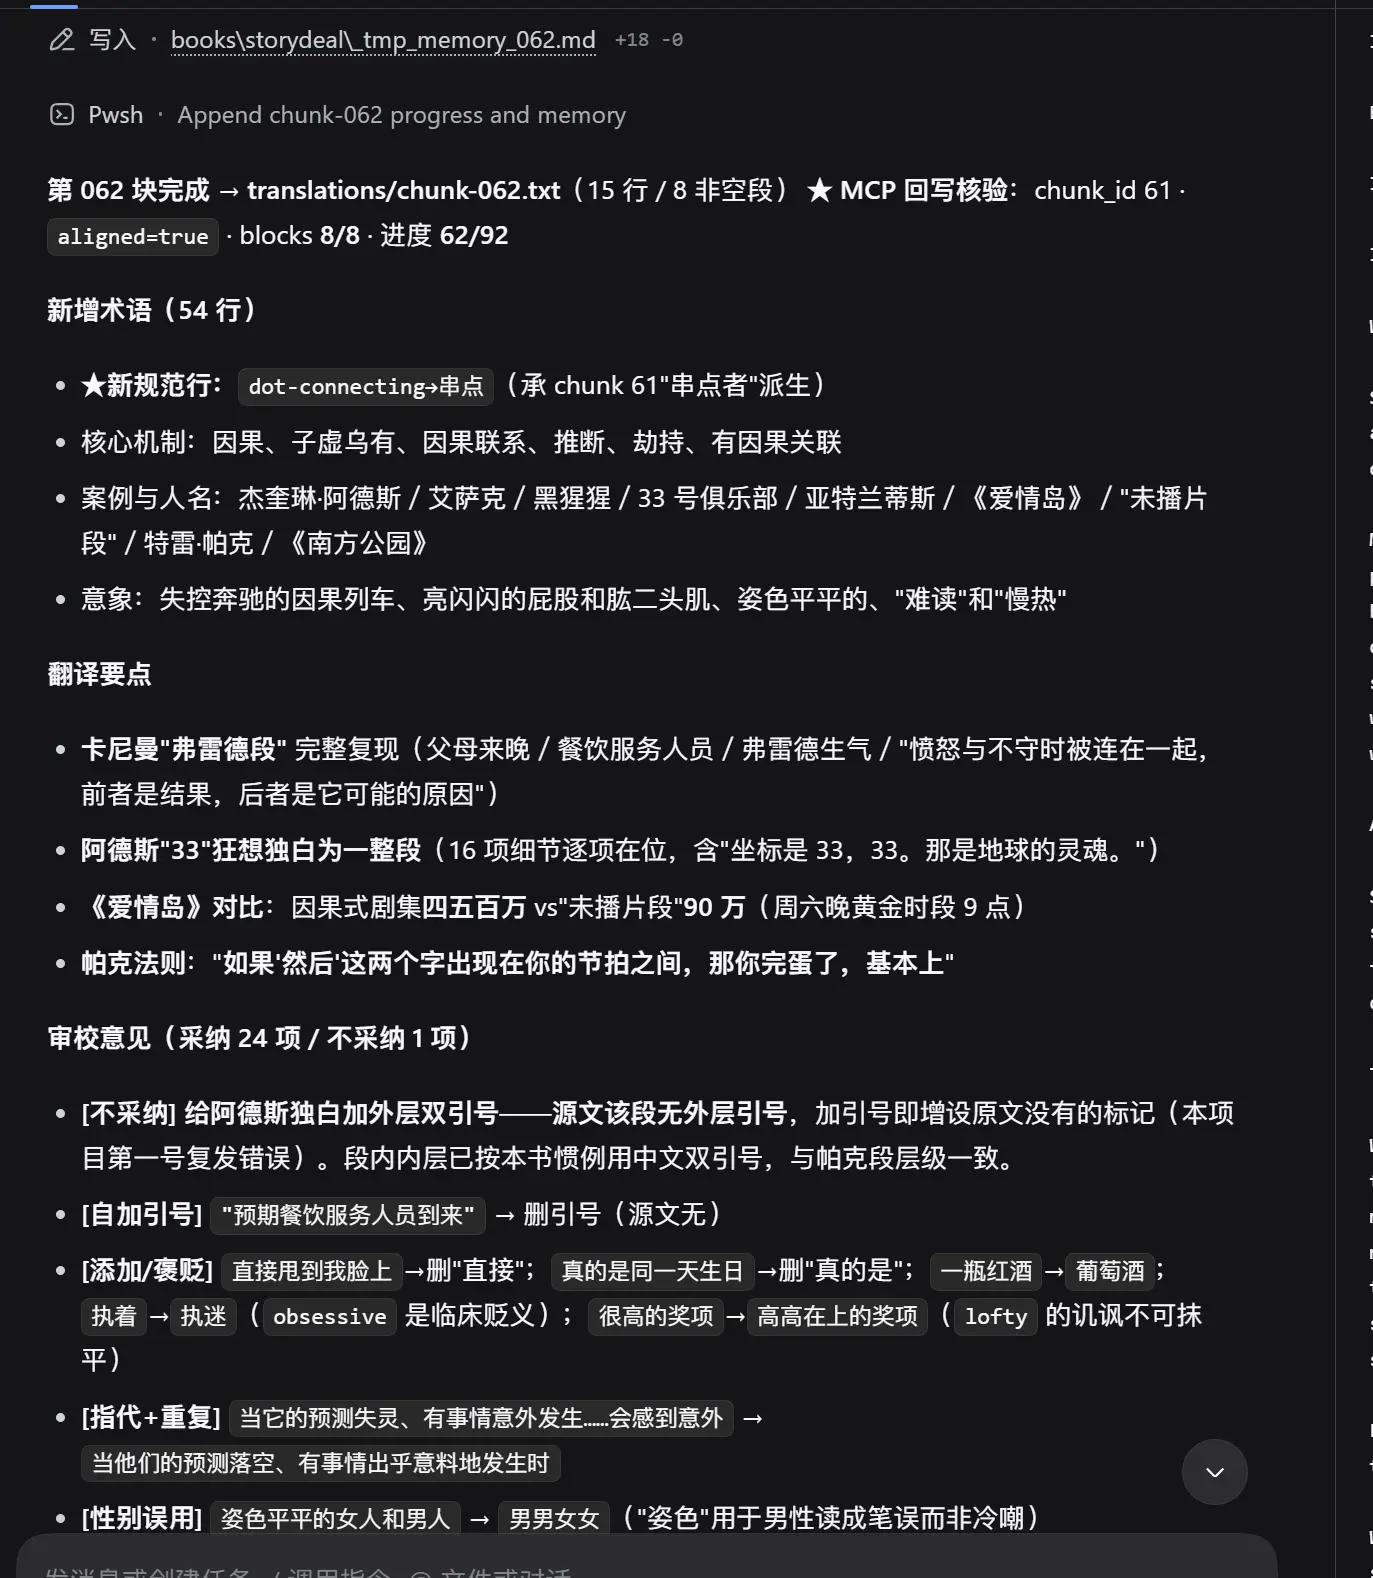
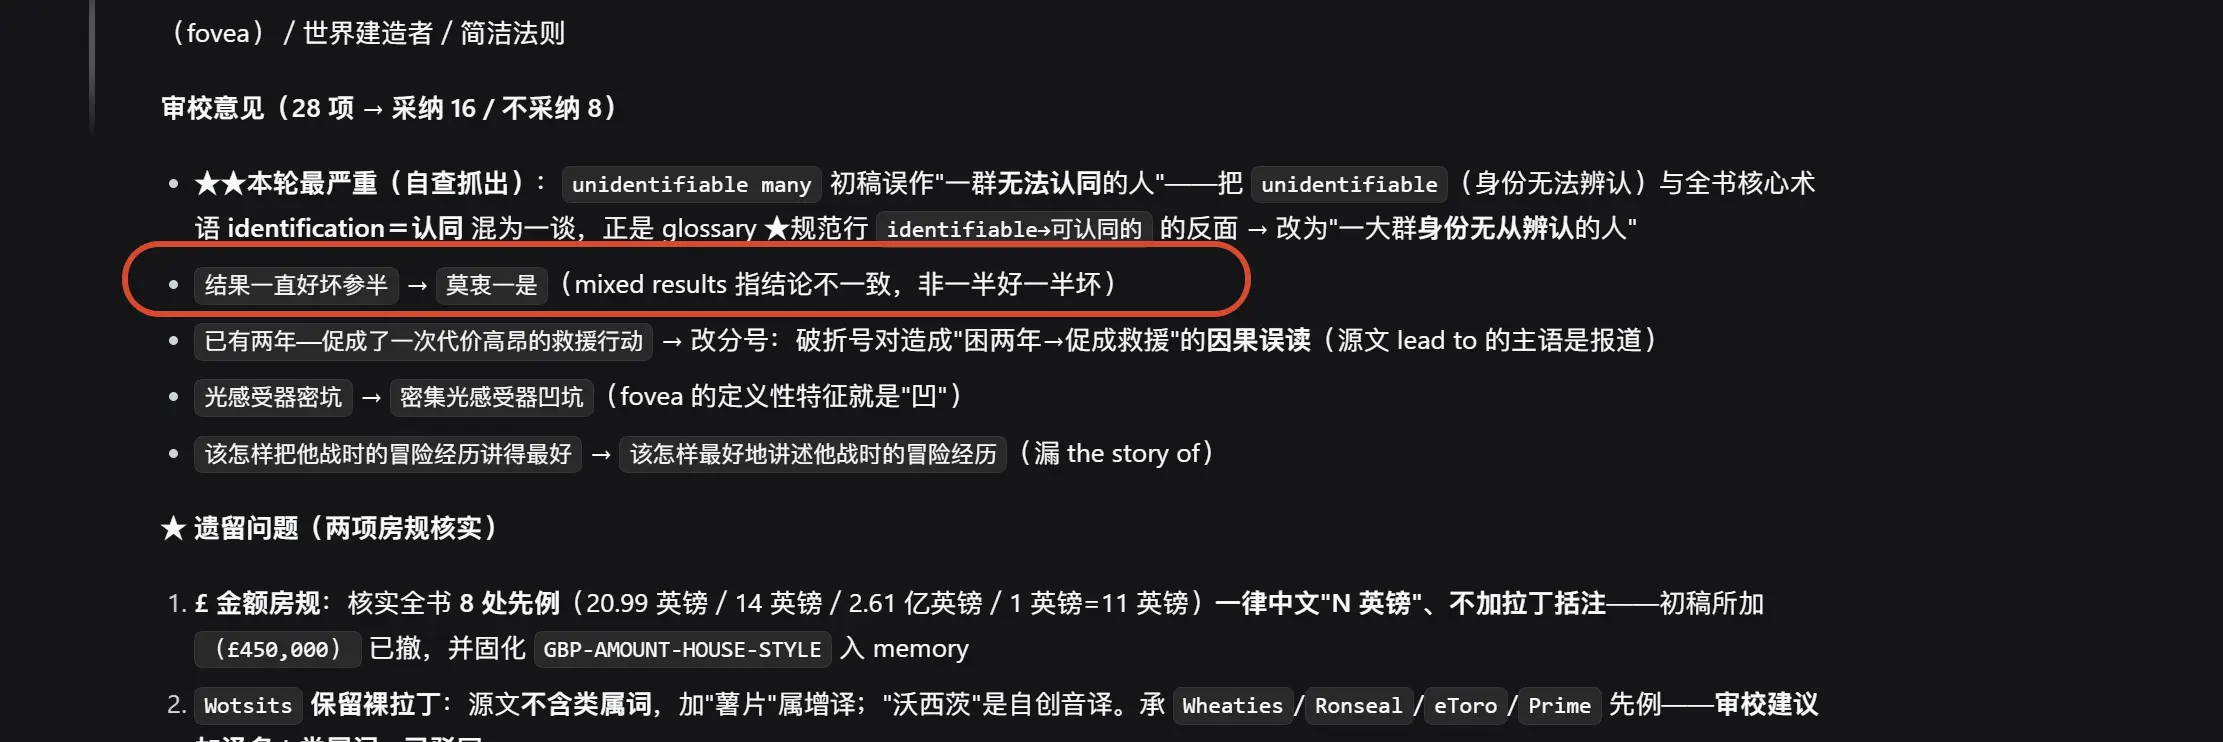
图 主对话框输出本轮翻译核心信息